> For the complete documentation index, see [llms.txt](https://docs.powermonitor.com.br/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.powermonitor.com.br/es/principais-funcionalidades/alertas-em-tempo-real.md).
# Alertas personalizadas
Alertas personalizadas de Power Monitor: qué eventos generan alerta, umbrales y filtros definidos por la organización, canales (correo electrónico, Teams, Slack, Telegram y webhooks/ITSM) y la central
Una buena alerta es la que llega **antes de que el usuario se queje**, **a quien puede resolverlo** y **sin ruido**. Power Monitor vigila el entorno todo el tiempo y le deja decidir qué es importante, para quién y por qué canal.
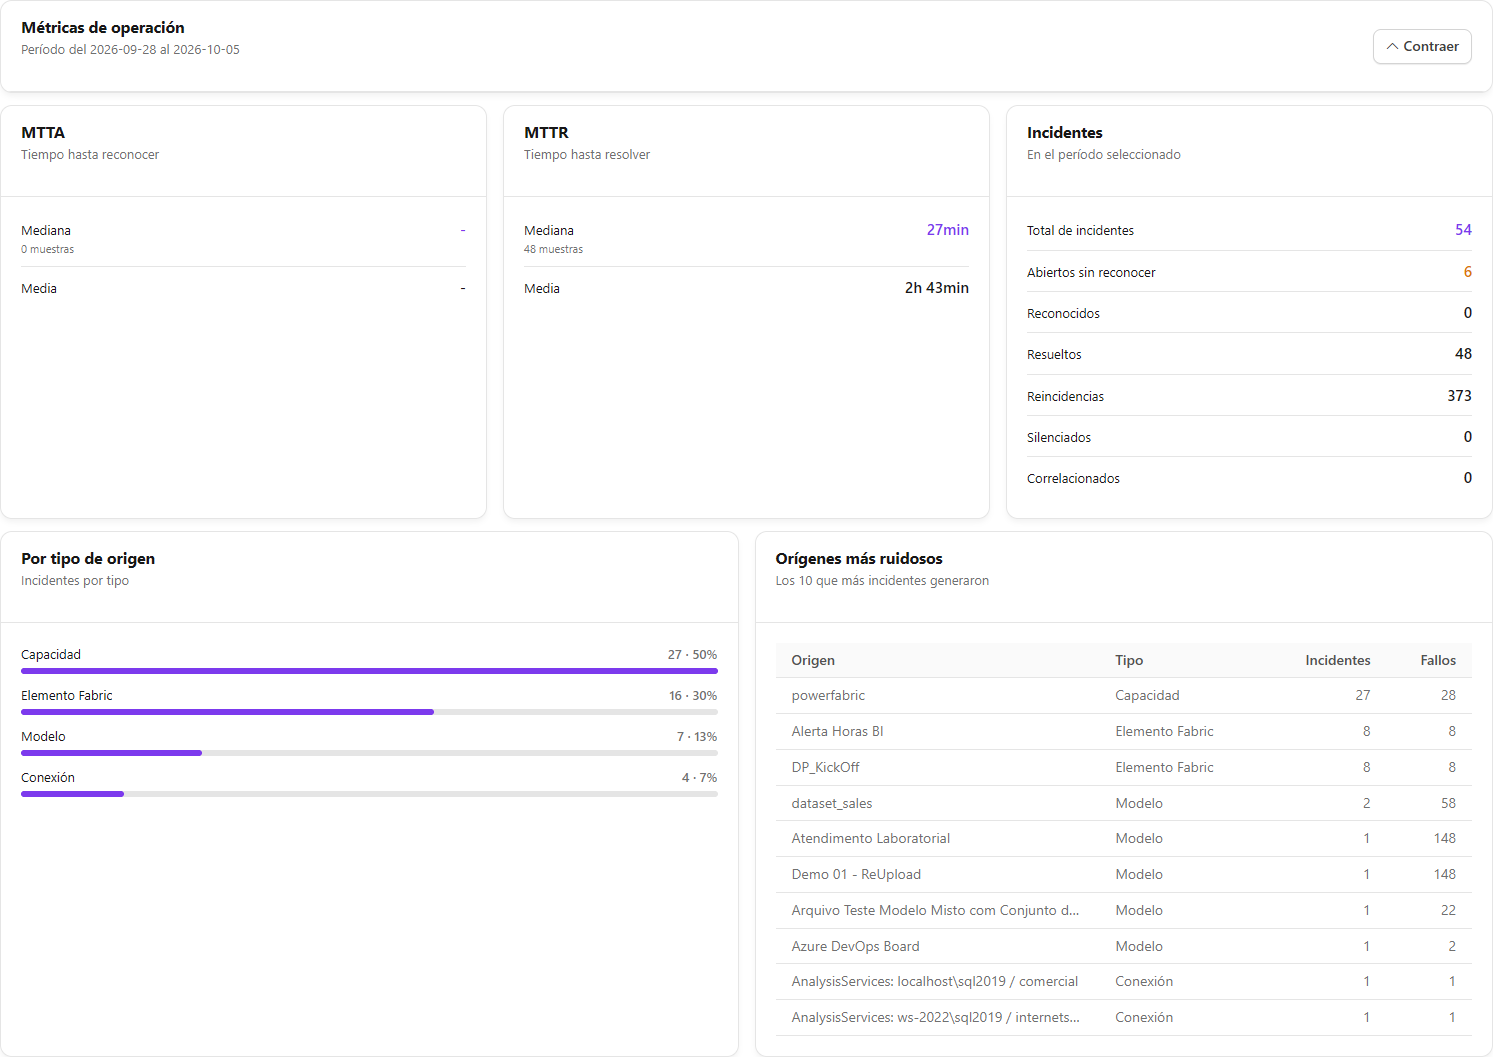
Central de incidentes con MTTA, MTTR y reincidencia
## Qué se convierte en alerta
| Área | Alertas |
| ------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Actualizaciones** | Falla de actualización de modelo semántico, falla en pipeline, notebook, Copy job o Dataflow Gen2, ejecución mucho más larga que el promedio, tablas con datos atrasados (Data Freshness), Fabric Mirroring con problemas |
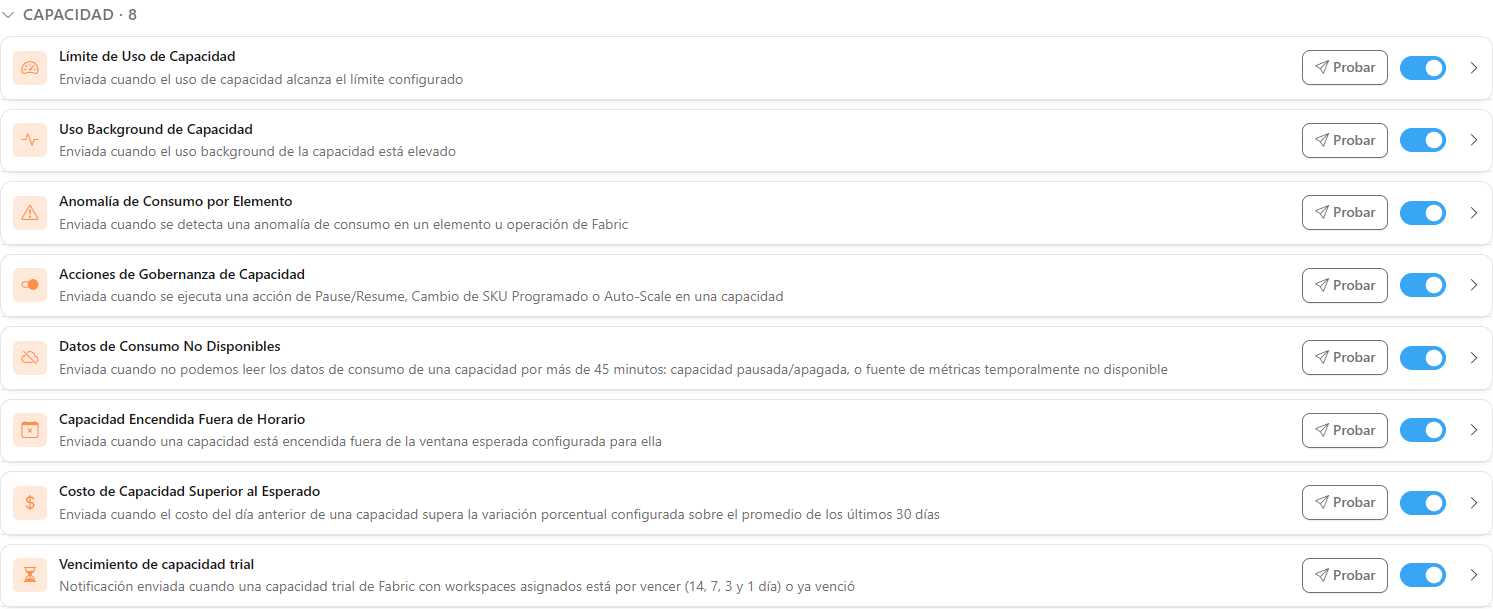
| **Capacidad** | Capacidad sin conexión, límite de uso total, uso en background por nivel, datos de consumo no disponibles, anomalía de consumo por elemento, capacidad encendida fuera del horario, capacidad de prueba a punto de vencer, acciones de pausa, reanudación y escalado ejecutadas |
| **Costo** | Costo diario por encima del promedio reciente, más allá del porcentaje definido |
| **Infraestructura** | Gateway sin conexión |
| **Resúmenes** | Checklist diario y checklist cada hora (enviado solo cuando hay algo que informar) y el aviso de **Alerta Resuelta** |
## A su manera
* **Umbrales que usted define:** el porcentaje de uso total que dispara la alerta de capacidad, los niveles Bajo, Medio, Alto y Crítico del uso en background, la variación de costo que se considera fuera de lo normal y la tolerancia de cada tabla en el Data Freshness.
* **Filtros por criticidad:** reciba fallas solo de los workspaces o elementos más críticos y deje el resto para el checklist.
* **Destinatarios por alerta:** cada tipo de alerta tiene su propia lista de quién la recibe, y los usuarios con alcance de workspaces solo reciben lo que les corresponde.
* **Aviso al creador del artefacto:** cuando falla un modelo semántico o un elemento de Fabric, el correo puede ir directo a quien lo mantiene, aunque esa persona no use Power Monitor.
* **Idioma y zona horaria de la organización:** los correos y mensajes salen en el idioma y en el horario de su equipo.
Cada alerta con sus destinatarios y reglas
## En los canales que su equipo ya usa
* **Correo electrónico**, por el servidor de Power Monitor o por una cuenta SMTP de su empresa;
* **Microsoft Teams**, **Slack** y **Telegram**;
* **Webhooks** e integraciones con herramientas de ITSM, como **ServiceNow**, **PagerDuty**, **Opsgenie** y **Azure DevOps**, para que la alerta se convierta en un ticket automáticamente.
## Una central de incidentes de verdad
Cada alerta abre un **incidente** en *Monitoreo › Alertas*, que sigue el problema de principio a fin:
* **Reconocer, asignar y comentar**, para que todos sepan quién se está ocupando;
* **Silenciar** un elemento en mantenimiento y **escalar** lo que quedó demasiado tiempo sin respuesta;
* **Correlación** de incidentes con la misma causa (por ejemplo, varias actualizaciones que fallan porque se cayó un gateway);
* **Investigar con IA** la causa probable;
* **Métricas de operación:** tiempo medio hasta reconocer (**MTTA**), hasta resolver (**MTTR**), reincidencia y los orígenes que más incidentes generan.
## Páginas relacionadas
* [Alertas (central de incidentes)](/es/power-monitor/monitoramento/alertas.md)
* [Notificaciones](/es/power-monitor/configuracoes/notificacoes.md): quién recibe cada alerta, filtros y umbrales
* [Alertas (canales)](/es/power-monitor/configuracoes/alertas.md): SMTP, Teams, Slack, Telegram, webhooks e ITSM
* [¿Cómo funciona el monitoreo proactivo?](/es/perguntas-frequentes/duvidas-gerais/como-funciona-o-monitoramento-proativo.md)
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.powermonitor.com.br/es/principais-funcionalidades/alertas-em-tempo-real.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.